中級向け
n8n でエラーが起きたとき、後続ノードには何が届くのか
On Error の3つの選択肢を、3件中1件だけが失敗する構成で実際に動かして比較しました。Continue とエラー出力では、届くアイテムの中身が違います。Retry On Fail の既定回数も実測しています。
公開 最終更新
動作確認: — n8n 2.36.8
ワークフローを本番で動かすと、必ずどこかで失敗します。APIが落ちる、認証が切れる、 想定外のデータが混ざる。そのとき n8n がどう振る舞うかは、ノードの Settings タブにある On Error で決まります。
選択肢は3つです。名前を見れば何となく想像はつきます。ただ、「続行」を選んだときに 後続ノードへ何が届くのかは、実際に動かして中身を見るまで分かりませんでした。 そして2つの「続行」は、届くものが違います。
ここでは 3件のうち2件目だけが失敗する ワークフローを作り、設定を切り替えながら 同じ内容を3回実行して、実行データを比較しました。
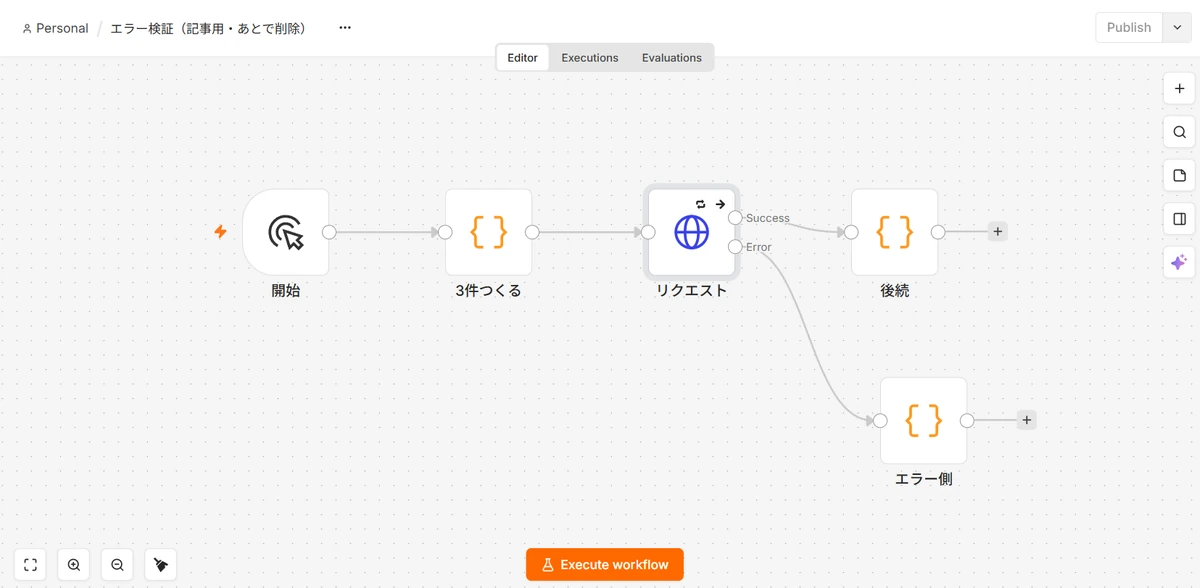
検証に使った構成
Code ノードで3件のアイテムを作り、それぞれの url を
HTTP Request ノードに渡します。2件目だけが認証エラー(401)になるURLです。
return [
  { json: { name: '1件目 成功', url: 'http://localhost:5678/healthz' } },
  { json: { name: '2件目 失敗', url: 'http://localhost:5678/rest/workflows' } },
  { json: { name: '3件目 成功', url: 'http://localhost:5678/healthz' } },
];
外部のサービスに依存させたくなかったので、n8n 自身のエンドポイントを使っています。
/healthz は {"status":"ok"} を返し、/rest/workflows は認証なしだと 401 を返します。
On Error の3つの選択肢
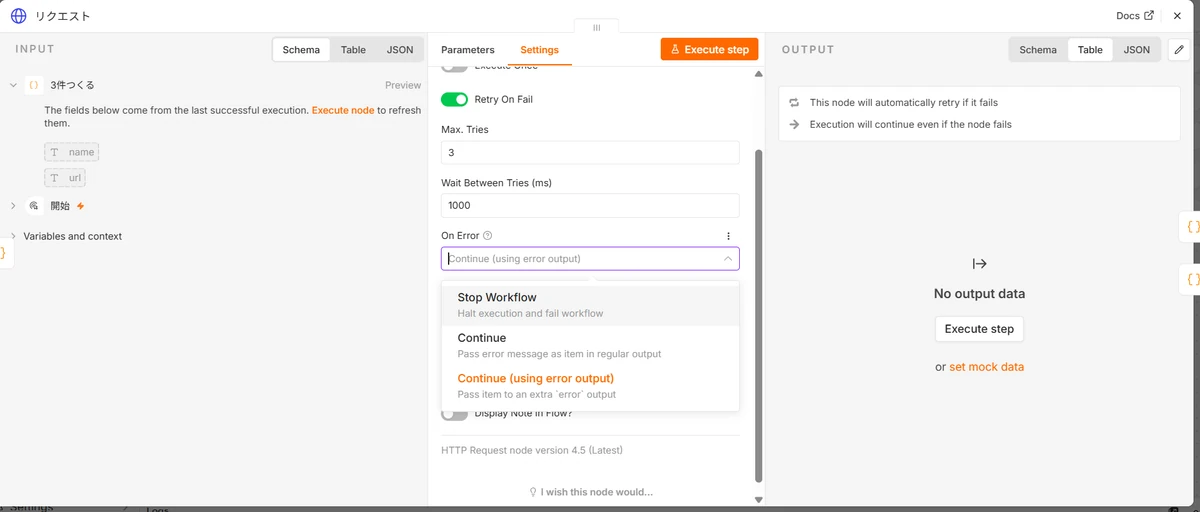
Settings タブを開くと On Error があります。選択肢の表記はこうです。
| 画面の表記 | 説明文 |
|---|---|
| Stop Workflow | Halt execution and fail workflow |
| Continue | Pass error message as item in regular output |
| Continue (using error output) | Pass item to an extra error output |
既定は Stop Workflow です。
ここで1つ注意があります。ワークフローのJSONやAPIで見える内部名は、画面の表記と違います。
| 内部名 | 画面の表記 |
|---|---|
stopWorkflow |
Stop Workflow |
continueRegularOutput |
Continue(「regular output」は説明文にしか出ない) |
continueErrorOutput |
Continue (using error output) |
内部名だけを見て「Continue (using regular output) という選択肢がある」と書くと間違いになります。 実際、この記事を書く途中で一度間違えました。
結果:3つで何が変わったか
同じワークフローを3回実行した結果です。
| On Error | 実行全体の結果 | 後続ノードに届いたもの |
|---|---|---|
| Stop Workflow(既定) | error | 何も届かない |
| Continue | success | 3件すべて(2件目はエラー内容に置き換わる) |
| Continue (using error output) | success | Success に2件、Error に1件 |
既定では、成功した分まで消える
一番意外だったのがここです。
Stop Workflow では、失敗した2件目だけでなく、成功した1件目の結果も後続に渡りません。
実行データを見ると、HTTP Request ノードの記録は executionStatus: "error" になっていて、
出力データそのものが存在しません。
"リクエスト": [{
  "executionStatus": "error",
  "error": { ... }
  // data キーがない
}]そして後続ノードには、実行記録が1つも残りません。「0件で実行された」のではなく、 実行されなかったということです。
これは IF ノードで条件に合わなかった側と同じ挙動でした。 n8n の実行記録は「動いたノード」しか残らない、と考えておくと読み間違えません。
なお、エラーの中身には どのアイテムで失敗したか が入っています。
"context": { "itemIndex": 1 }itemIndex は0から数えるので、1 は2件目です。100件流して1件だけ落ちたとき、
これが分かるかどうかで調査時間が変わります。
Continue は、元の入力データを捨てる
ここが実務で一番効く違いです。
Continue を選ぶと、3件とも後続に届きます。実行全体も success になります。 失敗した2件目は、こういうアイテムに 置き換わります。
{
  "error": {
    "message": "401 - \"{\\\"status\\\":\\\"error\\\",\\\"message\\\":\\\"Unauthorized\\\"}\"",
    "name": "AxiosError",
    "code": "ERR_BAD_REQUEST",
    "status": 401
  },
  "details": {
    "message": "Authorization failed - please check your credentials",
    "httpCode": "401",
    "context": { "itemIndex": 1 }
  }
}
name も url も残っていません。 入力に入れていたはずの
{ name: '2件目 失敗', url: '...' } は、どこにもありません。
つまり Continue では、どのデータで失敗したのかが分からなくなります。
details.context.itemIndex で「2件目」とは分かりますが、その2件目が何だったかは、
上流のノードを辿り直さないと分かりません。
もう1つ、地味に危ないのはこれです。後続ノードから見ると、エラーのアイテムも
ただの1件として流れてきます。 $json.status を読むつもりのコードは undefined を受け取り、
そのまま次に進みます。エラーが握りつぶされたまま、おかしなデータが下流へ流れていきます。
Continue を使うなら、後続でエラーのアイテムを弾く処理が必要です。
エラー出力なら、どのデータで失敗したか分かる
Continue (using error output) を選ぶと、ノードの出力が Success と Error の 2本になります(キャンバス上にもそうラベルが出ます)。
- Success に成功した2件
- Error に失敗した1件
そして Error 側に届いたアイテムは、中身がまったく違いました。
{
  "name": "2件目 失敗",
  "url": "http://localhost:5678/rest/workflows",
  "error": { ... },
  "details": { ... }
}元の入力(name と url)が残った上に、エラー情報が足されています。
Continue では消えていたものが、エラー出力では残ります。同じ「続行」でも、 失敗したデータを後から再処理できるかどうかが変わります。 失敗分だけをログに書く、あとでまとめて再実行する、といった処理はエラー出力でないと組めません。
この違いはノードの定義を読んでも書かれていません。両方を実際に動かして、 出てきたアイテムを並べて初めて分かりました。
Retry On Fail の既定は3回・1秒
Retry On Fail をオンにすると、Max. Tries と Wait Between Tries (ms) が出てきます。
欄には 3 と 1000 が入っています。
この「3」が合計の試行回数なのか再試行の回数なのかは、表示からは読み取れません。 実行時間を測って確かめました。
| 設定 | ノードの実行時間 | 待ちの回数 |
|---|---|---|
| 再試行なし | 104ms | 0回 |
| 既定(Max. Tries = 3) | 2,055ms | 2回 |
| Max. Tries = 5 | 4,107ms | 4回 |
待ち時間は (Max. Tries − 1) × Wait Between Tries でした。
つまり Max. Tries は合計の試行回数 で、既定の3なら 初回1回+再試行2回 です。
実務上の意味はこうです。再試行をオンにすると、そのノードが失敗したときの所要時間が 数秒単位で伸びます。 100件を1件ずつ叩くワークフローで多くが失敗すると、 待ち時間だけで積み上がります。Wait Between Tries は最大5000msまで指定できるので、 長くするときは総時間を意識してください。
「続行」にすると、再試行は効かなくなる
この記事の初版では「Retry On Fail と On Error は独立しています。両方を設定できます」と 書いていました。これは誤りでした。 組み合わせを試さずに書いたのが原因です。測り直しました。
同じ失敗(存在しないURLへの404)に対して、Retry On Fail: true / Max. Tries: 3 を
入れたまま On Error だけを変えて実行した結果です。
| On Error | ノードの実行時間 | 再試行 |
|---|---|---|
| Stop Workflow | 2,793ms | された(1秒 × 2回の待ち) |
| Continue | 430ms未満 | されない |
| Continue (using error output) | 343ms未満 | されない |
On Error を「続行」のどちらかにすると、Retry On Fail は発動しません。 設定欄は有効なままで、警告も出ません。再試行しているつもりで、していない状態になります。
理屈としては、こう考えると辻褄が合います。続行を選んだノードは、失敗を自分で処理して アイテムに変換するため、エンジンから見ると「失敗していない」。再試行はエンジン側の 仕組みなので、そもそも出番が来ない。ただしこれは挙動からの推測で、実装は確認していません。 確かなのは上の実測値だけです。
実務上の意味は大きいです。「一時的な失敗は再試行したい、それでもダメなら失敗分を拾いたい」は、 1つのノードでは両立しません。 どちらかを選ぶことになります。
- 再試行を効かせたい →
Stop Workflowのまま。ただし1件でも失敗すると全部止まります - 失敗分を拾いたい → 続行を選ぶ。ただし再試行は諦めることになります
どれを選ぶか
検証した範囲では、こう整理できます。
- 1件でも失敗したら全部やり直したい → Stop Workflow(既定のまま)。 ただし成功した分の結果も消えることを前提に組むこと
- 失敗した分を後で拾いたい → Continue (using error output)。 元データが残るのはこれだけです
- Continue は、エラーの中身を後続でそのまま扱いたいときに限る。 元データが消えるので、選ぶ理由がなければエラー出力の方が安全です
一時的な失敗(レート制限、タイムアウト)が想定されるなら、Stop Workflow のまま Retry On Fail を使うことになります。上に書いたとおり、続行と再試行は併用できません。
どうしても両方ほしい場合は、ノードを2段に分ける(1段目は Stop Workflow + 再試行、 そこで落ちたものを別経路で拾う)といった組み方が要ります。 この組み方は試していないので、動く保証はできません。
検証していないこと
裏付けが取れていない点を明記しておきます。
- エラーワークフロー(Error Trigger)との関係。 当初この記事では「資料を読んだだけで 自分では動かしていない」と書いていました。その後、実際に検証しました。 手動実行では本当に発火しません。結果は n8n のエラー通知は、手動実行では飛ばない にまとめています
- 検証したのは HTTP Request ノード1種類だけです。On Error はどのノードにもある共通設定ですが、 他のノードで同じ形のアイテムが出るかは確認していません
- 失敗のさせ方は 401(認証エラー)と 404(存在しないURL)の2パターンです。
タイムアウトやDNSエラーで
errorの中身がどう変わるかは見ていません - 「続行だと再試行が効かない」理由として書いた説明は、挙動からの推測です。 n8n の実装は読んでいません
エラーの出方そのものより、**エラーのときに何が「消えるか」**を知っておく方が、 設計では効きました。
- アイテムの考え方は n8n 用語集 にまとめています
- 失敗しやすい HTTP まわりの設定は HTTP Request ノードの使い方 に書きました
- 条件分岐で「通らなかった側」が同じように記録に残らない話は IF ノードの使い方 にあります