中級向け
n8n Mergeノードの使い方:2つのデータを突き合わせるときに消えるもの
n8nのMergeノードで2系統のデータを結合する方法を、実際に動かして確認した結果とあわせて解説します。既定では一致しなかった項目が消え、数値と文字列も別物として扱われます。
公開
動作確認: — n8n 2.36.8 / Merge ノード v3.2
2つの流れに分かれたデータを1つにまとめるのが Mergeノードです。 「別々のAPIから取ったデータを、IDで突き合わせる」といった処理に使います。
この記事はn8n の基本操作ができる人向けです。 IFやSwitchで分けたデータを合流させたり、 2つのデータソースを結合したりする場面を想定しています。
内容は n8n 2.36.8 / Merge ノード v3.2 で実際に動かして確認しています。 検証の過程で、ドキュメントを読んだだけでは分からない挙動が2つ見つかりました。
Mergeノードは何をするものか
複数の入力を受け取って、1つの出力にまとめるノードです。
他のノードと違って入力が2つ以上あります(既定は2つ、最大10まで増やせます)。 そして重要な性質として、つながっているすべての入力の処理が終わるまで待ちます。
まとめ方には4つのモードがあります。
| モード | 何をするか |
|---|---|
| Append | 入力1の全件、続いて入力2の全件、と順に並べる |
| Combine | 条件に従って1件ずつ突き合わせて合体させる |
| SQL | SQLのクエリを書いて結合する |
| Choose Branch | 片方の入力のデータだけを出す |
単純に「両方のデータを並べたい」だけなら Append、 「IDで紐づけて1件にまとめたい」なら Combine です。
Combine の3つの方式
Combine を選ぶと、さらに3つから選べます。
| 方式 | 突き合わせ方 |
|---|---|
| Matching Fields(既定) | 指定したフィールドの値が同じものを結合 |
| Position | 1件目と1件目、2件目と2件目、と順番で結合 |
| All Combinations | 全組み合わせを作る |
実務で最も使うのが Matching Fields です。
「入力1の id と入力2の id が同じものをまとめる」という使い方をします。
既定では、一致しなかった項目が消える
ここが最大の注意点です。
Matching Fields には Output Type という設定があり、既定は Keep Matches
(一致したものだけを残す)です。
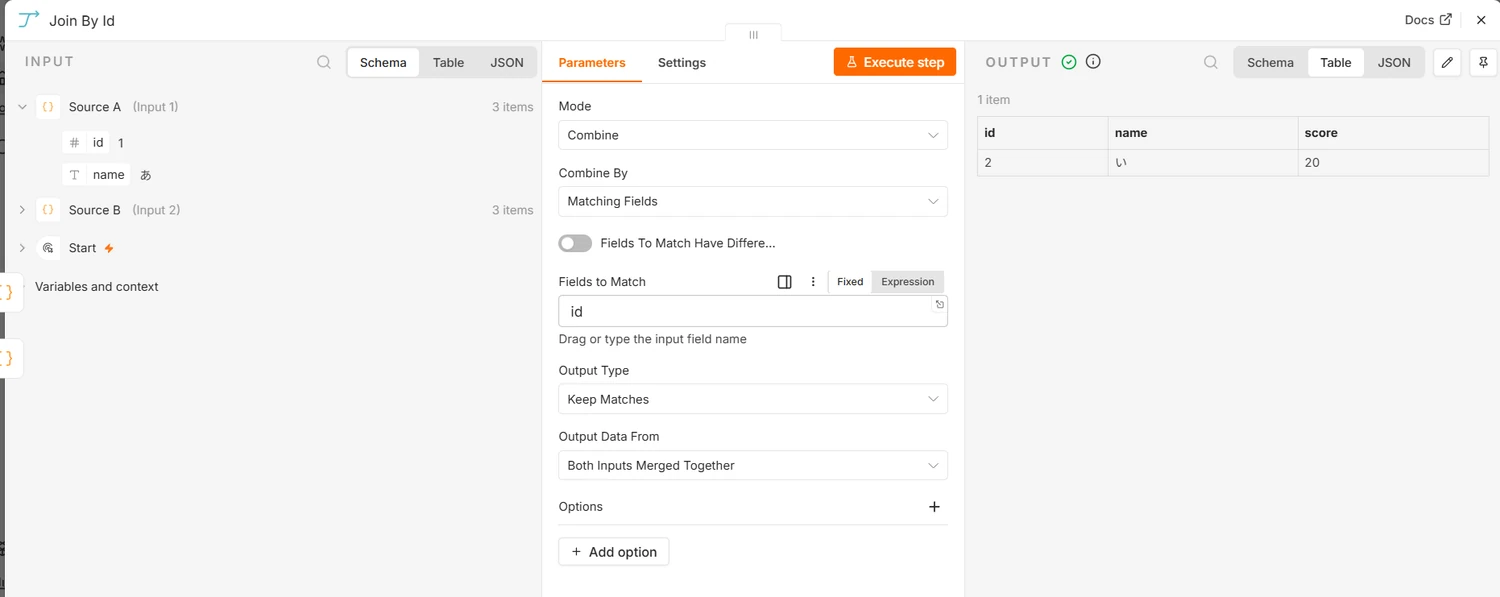
設定名は Output Type です。 「結合の方法」ではなく「何を出力するか」という
名前になっているので、探すときに見落としやすい項目です。
実際に確認した結果
次の2つのデータを id で突き合わせました。
| 入力1 | 入力2 |
|---|---|
{ id: 1, name: 'あ' } |
{ id: '1', score: 10 } |
{ id: 2, name: 'い' } |
{ id: 2, score: 20 } |
{ id: 3, name: 'う' } |
{ id: 9, score: 90 } |
3件と3件を入れて、出力は1件だけでした。
{ "id": 2, "name": "い", "score": 20 }消えた理由は2つあります。
id: 3とid: 9は相手がいないので、Keep Matches では出力されないid: 1とid: '1'は一致しなかった
2つ目が次の話です。
数値と文字列は別物として扱われる
Fuzzy Compare という設定があり、既定はオフです。 この項目は最初から見えているわけではなく、Options の「+ Add option」から追加すると現れます。
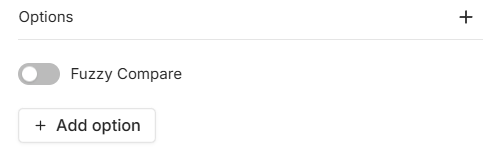
オフのままだと、数値の 1 と文字列の '1' は一致しません。
APIから返ってくるIDは、見た目が数字でも文字列であることが珍しくありません。 片方がデータベース由来の数値、もう片方がAPI由来の文字列、という組み合わせで 「なぜか1件も一致しない」という状態になります。
Fuzzy Compare をオンにすると、型の違いを吸収して比較します。
先ほどのデータで試したところ、id: 1 と id: '1' が一致するようになりました。
{ "id": "1", "name": "あ", "score": 10 }
{ "id": 2, "name": "い", "score": 20 }ただし型が揃っているのが本来あるべき姿です。 Fuzzy Compare は応急処置として使い、可能なら Edit FieldsやCodeで型を揃えておく方が、 後から見たときに分かりやすくなります。
一致しなかった項目も残すには
ここは検証していなければ間違えるところでした。
Options には Include Any Unpaired Items(対になっていない項目も含める)という 設定があります。名前から「一致しなかった項目も含める設定」に見えます。
しかし、これをオンにしても id: 3 と id: 9 は出てきませんでした。
この設定は、件数が違うときの扱いに関するもので、
Matching Fields で一致しなかった項目を拾う用途ではないようです。
正しいのは Output Type を変えることです。
| Output Type | 出力されるもの |
|---|---|
Keep Matches(既定) |
一致したものだけ |
Keep Non-Matches |
一致しなかったものだけ |
Keep Everything |
両方。一致したものも、しなかったものも |
Keep Everything にして実行したところ、4件すべてが出力されました。
{ "id": "1", "name": "あ", "score": 10 }
{ "id": 2,   "name": "い", "score": 20 }
{ "id": 3,   "name": "う" }
{ "id": 9, "score": 90 }一致しなかった項目は、持っている側のフィールドだけを持った状態で出てきます。
id: 3 には score がなく、id: 9 には name がありません。
後続の処理では、フィールドが無い場合を考慮する必要があります。
同じ名前のフィールドがぶつかったら
入力1と入力2の両方に同じ名前のフィールドがある場合、 Clash Handling でどちらを優先するか決められます。
既定は後の入力を優先し、入れ子のフィールドは深く結合します。 「片方が空のときだけもう片方を使う」という設定もあります。
意図しない上書きは気づきにくいので、 結合前にフィールド名が重複していないか確認しておくと安全です。
うまくいかないときの切り分け
- 1件も出力されない — 型が違っていないか。Fuzzy Compare を試す
- 件数が減っている — Output Type が
Keep Matchesのままではないか - フィールドが無いと言われる — 一致しなかった項目は片側のフィールドしか持たない
- 値が上書きされている — 同名フィールドの Clash Handling を確認する
- ノードが動かない — すべての入力がつながって実行されるまで待つ仕様
次に読む
- n8n Switchノードの使い方 — 分けたデータを Merge で合流させる
- n8n Edit Fields(Set)ノードの使い方 — 結合前に型やフィールド名を揃える
- コアノードの一覧 — ほかのよく使うノード