中級向け
n8n Aggregateノードの使い方:項目が欠けると一覧の添字がずれる
複数のアイテムを1件にまとめるノードです。既定のままだと値が欠けているアイテムを飛ばすため、2つの項目をまとめたときに別のレコード同士が対応してしまいます。実際に動かして確認し、防ぎ方もまとめました。
公開
動作確認: — n8n 2.36.8 / Aggregate ノード v1
Aggregate は、複数のアイテムを1件にまとめるノードです。
10件の注文データを1件にまとめて、まとめてメールで送る。名前の一覧を作って 「田中、鈴木、佐藤」と並べる。そういう使い方をします。
Split Out がバラすノードなら、こちらはその逆です。
ただし既定のままだと、値が欠けているアイテムを黙って飛ばします。 その結果、別のレコード同士が対応してしまうことがあります。実際に起こしてみました。
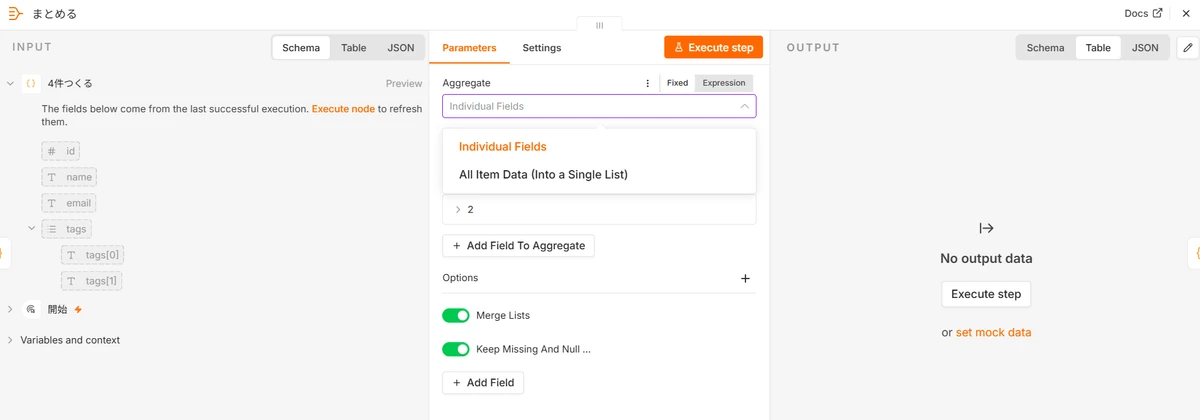
2つのまとめ方がある
| 表記 | 何をするか |
|---|---|
| Individual Fields(既定) | 指定した項目だけを取り出し、項目ごとの一覧にする |
| All Item Data (Into a Single List) | アイテムまるごとを1つの配列にまとめる |
この2つは結果がかなり違います。 どちらを選ぶかで、後で困るかどうかが変わります。
添字がずれる
4件のデータを用意しました。2件目には email がなく、4件目は email が null です。
{ id: 1, name: '田中', email: 'tanaka@example.com' }
{ id: 2, name: '鈴木' }                              // email が無い
{ id: 3, name: '佐藤', email: 'sato@example.com' }
{ id: 4, name: '高橋', email: null }                 // email が null
Individual Fields で name と email をまとめた結果です。
{
  "name":  ["田中", "鈴木", "佐藤", "高橋"],
  "email": ["tanaka@example.com", "sato@example.com"]
}
name は4件、email は2件になりました。
値が無いものと null の両方が飛ばされていました。4件中2件が欠けたので、2件になっています。
添字を揃える
Options に Keep Missing And Null Values があります。既定はオフです。
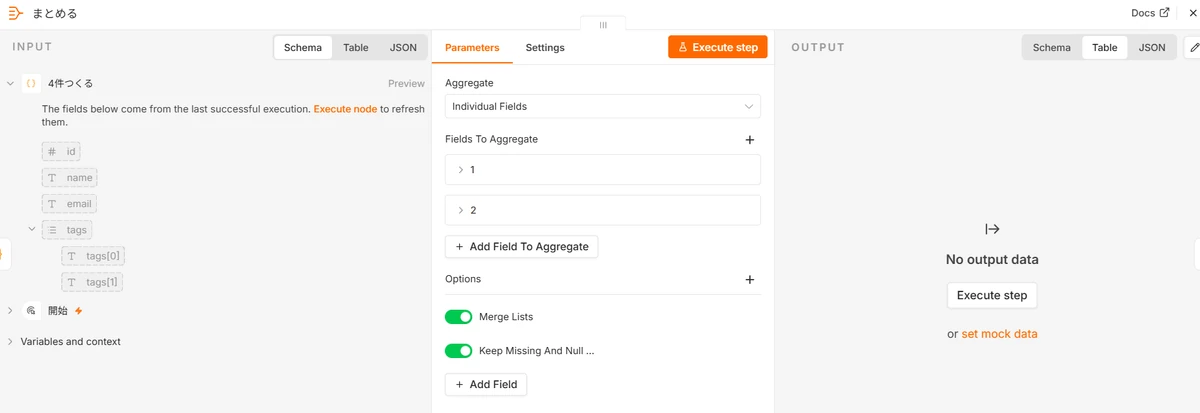
これをオンにして同じデータを流すと、こうなりました。
{
  "name":  ["田中", "鈴木", "佐藤", "高橋"],
  "email": ["tanaka@example.com", null, "sato@example.com", null]
}
欠けていたところに null が入り、4件で揃いました。 添字の対応が崩れません。
配列の項目は「配列の配列」になる
まとめたい項目が、もともと配列だった場合です。
{ tags: ['A', 'B'] }
{ tags: ['C'] }
{ tags: [] }
{ tags: ['D'] }
既定のままだと、こうなります。
{ "tags": [["A","B"], ["C"], [], ["D"]] }配列が入れ子になります。 Options の Merge Lists をオンにすると、平らになりました。
{ "tags": ["A","B","C","D"] }ずれが怖いなら、もう一方のモード
All Item Data (Into a Single List) を選ぶと、結果はこうなりました。
{
  "data": [
    { "id": 1, "name": "田中", "email": "tanaka@example.com", "tags": ["A","B"] },
    { "id": 2, "name": "鈴木", "tags": ["C"] },
    { "id": 3, "name": "佐藤", "email": "sato@example.com", "tags": [] },
    { "id": 4, "name": "高橋", "email": null, "tags": ["D"] }
  ]
}
アイテムの形がそのまま保たれます。 欠けた項目は欠けたまま、null は null のまま。
添字のずれは原理的に起きません。
後続で使うときは {{ $json.data[0].name }} のように取り出します。
少し書き方は面倒ですが、対応関係を壊したくないならこちらが安全です。
使い分け
- 1つの項目を一覧にしたいだけ → Individual Fields でよい
- 2つ以上の項目を並べて使う → Individual Fields + Keep Missing And Null Values
- とにかく壊したくない → All Item Data
まとめた後のアイテムは1件になります。後続のノードは1回だけ動きます。
検証していないこと
Include(All Item Data のとき、どの項目を含めるか)はallFieldsだけ試しました。specifiedFieldsとallFieldsExceptは動かしていませんRename Field(出力の項目名を変える設定)は使っていません- バイナリデータは扱っていません。
Include BinariesとKeep Only Unique Binariesは未検証です Disable Dot Notationは試していません。 入れ子の項目をparent.childで指定したときの挙動は確認していません- 検証したのは4件という小さなデータです。件数が多いときの速度やメモリは見ていません
「一覧を2つ作って並べる」ときが一番危ないノードだと思います。 片方だけ短くなっていても、見た目では気づけません。
- バラす側は Split Outノードの使い方
- 複数の経路をまとめるなら Mergeノードの使い方
- アイテムの考え方は n8n 用語集 に