中級向け
n8nでClaudeを使う設定
AI Agent に Claude をつなぐノードです。APIキーの取得から設定まで一通り動かしたうえで、設定できるのに送信されない項目、UIでは選べないのに有効な値、選べるのにエラーになる組み合わせを実測しました。
公開
動作確認: — n8n 2.36.8 / Anthropic Chat Model v1.5 / AI Agent v3.1
Anthropic Chat Model は、AI Agent に Claude をつなぐためのノードです。 単体では動かず、AI Agent の下にぶら下げて使います。
つなぐだけなら10分で終わります。ただし設定項目のいくつかは、設定しても効きません。 エラーも警告も出ないまま、送信時に捨てられます。逆に、UIの選択肢に出ないのに 実際には有効な値もありました。
実際に9回実行して、n8n が Anthropic へ送った中身を1回ずつ確認した記録です。 消費したのは合計で約$0.023でした。
APIキーを取る前に知っておくこと
Anthropic の API は前払いクレジット制です。買った分を使い切ると、 リクエストがエラーになって止まります。従量で後から請求されることはありません。
| 項目 | 実際の値 |
|---|---|
| 最低チャージ額 | $5 |
| 消費税 | 10%($20なら合計$22) |
| 有効期限 | 購入から1年で失効 |
購入画面には「クレジットは API、Claude Code、Playground の利用で消費されます」と 書かれています。ここが後述の環境変数の話につながります。
クレデンシャルを登録する
n8n の Credentials → Add credential で Anthropic を選び、APIキーを貼ります (n8n が暗号化して保存する認証情報です)。
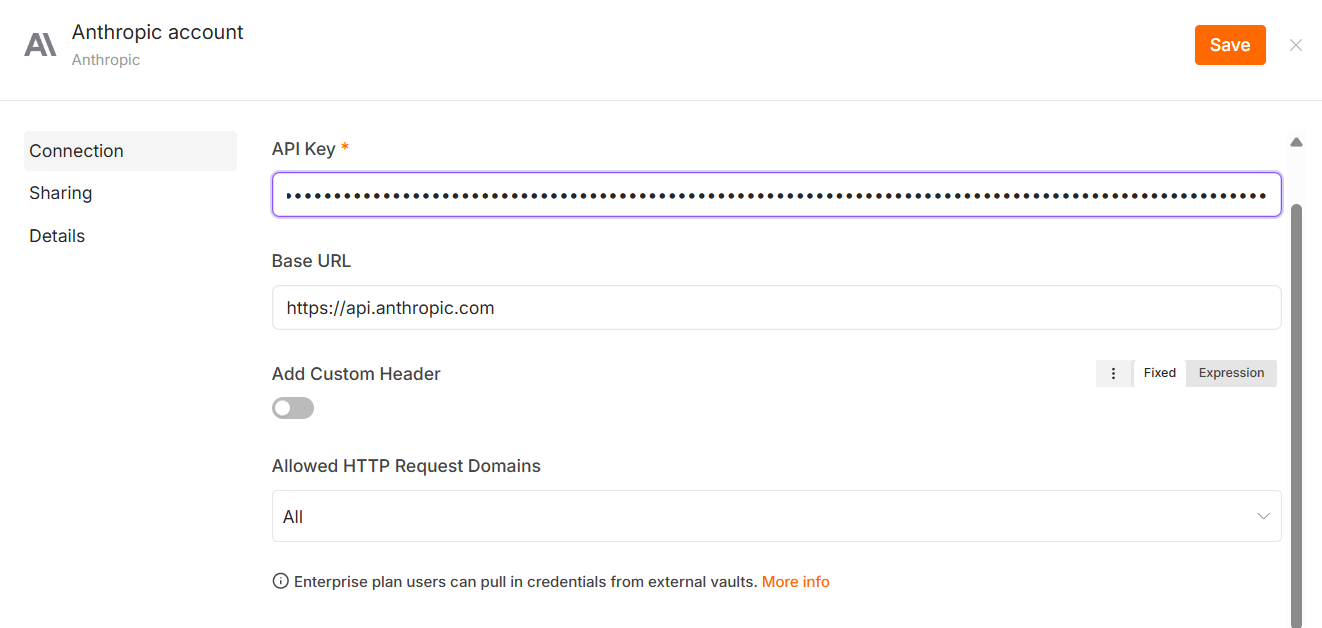
Base URL は変更不要です。Allowed HTTP Request Domains は HTTP Request ノードから
このクレデンシャルを使うときの制限で、Chat Model には影響しません。
なお、実行データを見るとAPIキーの位置に
{"lc":1,"type":"secret","id":["ANTHROPIC_API_KEY"]} と出ます。
これはLangChain が秘密情報を伏せるための内部表記で、環境変数を読んでいるという意味では
ありません。キーはクレデンシャルから渡っています。
まず1回動かす
Manual Trigger → AI Agent の構成を作り、AI Agent の下に Anthropic Chat Model を ぶら下げます。プロンプトは何でもかまいません。
これだけで動きます。以降は、動いたあとに実行データを開いて何が送られたかを見る話です。 n8n は AI Agent の下のノードにも実行記録を残すので、そこに実際のリクエスト設定が入っています。
設定項目は、ノードを開いた Options の中にあります。既定では何も入っていません。
Add Option を押して1つずつ足していく形です。
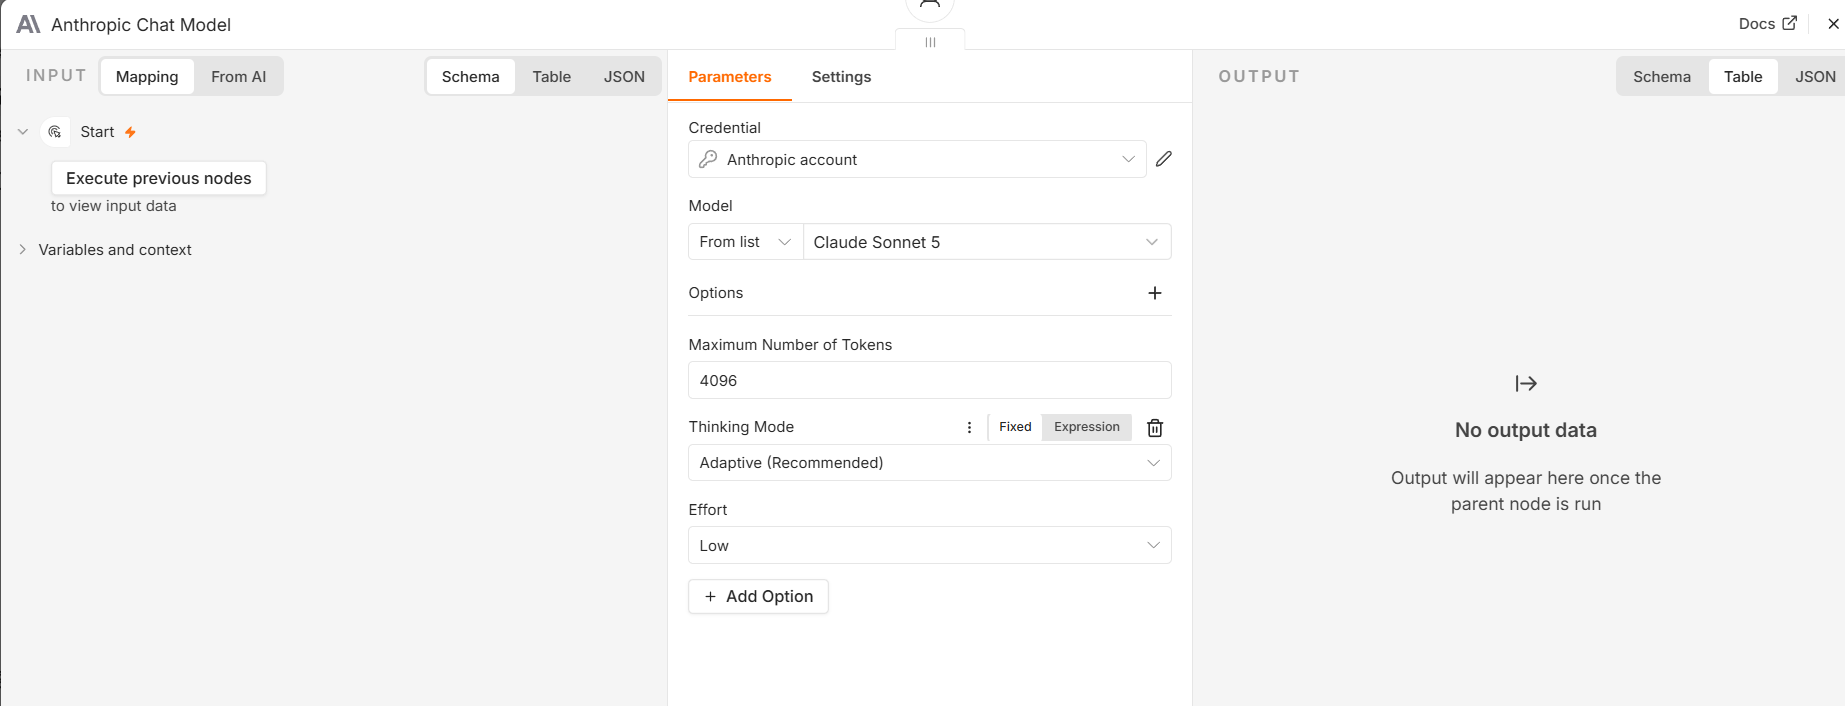
この「追加していない項目がどう扱われるか」が、いちばん読みにくい部分です。
選べるモデルは12種類ある
モデル一覧は API から動的に取得されるので、一覧に最新のモデルが並びます。 2026-09-27 時点で取得できたのは12種類でした。
claude-opus-5-5       claude-fable-5-1      claude-opus-5
claude-sonnet-5       claude-fable-5        claude-opus-4-8
claude-opus-4-7       claude-sonnet-4-6     claude-opus-4-6
claude-opus-4-5-20251101
claude-haiku-4-5-20251001
claude-sonnet-4-5-20250929
IDの形式が揃っていません。 新しい9種類は claude-sonnet-5 のような素のIDですが、
4.5世代の3つだけ日付が付きます。一覧から選ぶ分には問題ありませんが、
From list を By ID に切り替えて手入力する場合は踏みます。
Max Tokens は、設定しないと16384だった
最初に見つかったのがこれです。ノード定義には既定値 4096 と書かれています。 ところが実際に送られた値は違いました。
| Options の状態 | 実際に送られた max_tokens |
|---|---|
| Maximum Number of Tokens を追加していない | 16384 |
| 追加した(欄の表示は 4096) | 4096 |
4096 は「その項目を追加したときに欄へ入る値」であって、
「項目が無いときの動作値」ではありませんでした。
これは HTTP Requestノードの Timeout とまったく同じ構造です。 あちらも定義上は10秒で、実際に未設定で動かすと5分でした。別のノードで同じ形が再現しています。
temperature は、新しいモデルでは送られない
temperature: 0.2 を設定したまま、モデルだけを差し替えて実行しました。
変えたのはモデル1箇所だけです。
| モデル | 送信された temperature |
|---|---|
| Claude Haiku 4.5 | 0.2 |
| Claude Sonnet 4.6 | 0.2 |
| Claude Sonnet 5 | キーごと消える |
エラーも警告も出ません。設定した値は保存されたままです。
ノード定義にも「Claude Opus 4.7以降、Claude Sonnet 5以降ではサポートされず無視される」と
書かれており、実測と一致しました。topK と topP にも同じ注記があります。
同じ文章でもモデルによってトークン数が違う
Reply with exactly: OK という同じプロンプトの入力トークン数です。
| モデル | 入力トークン |
|---|---|
| Claude Haiku 4.5 / Claude Sonnet 4.6 | 12 |
| Claude Sonnet 5 | 16(+33%) |
新しい世代はトークンの数え方が変わっており、 同じ文章でもトークン数が増えます。
単価表だけ見て安いモデルに移ると、思ったほど安くなりません。 この実行を実際の単価で計算すると、Sonnet 4.6 が $0.000096、Sonnet 5 が $0.000072。 単価は33%安いのにトークンが33%増えるので、差は約25%に縮みます。 Sonnet 5 の方が安いという結論自体は変わりませんが、幅は単価表の印象より小さいです。
Effort は、モデルによって選択肢が減る
Thinking Mode を Adaptive にすると Effort が出ます。この選択肢の数がモデルで違いました。
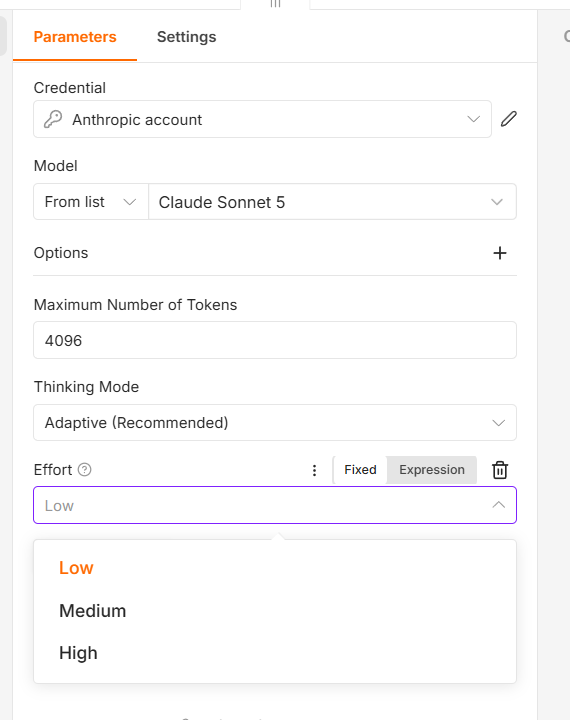
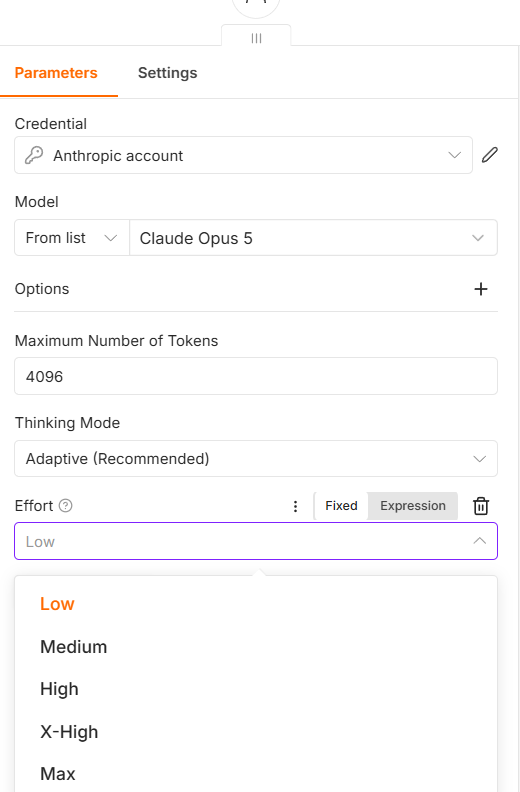
n8n はモデル名に opus を含むかどうかで選択肢を切り替えています。
ところが Anthropic の API は、Sonnet 5 でも xhigh と max を受け付けます。
そこで UIを経由せずに xhigh を書き込んで実行してみました。
| effort | 出力トークン | 実行時間 | 答え |
|---|---|---|---|
| Low | 525 | 14.1秒 | 正解 |
| X-High | 1,731 | 16.4秒 | 正解 |
エラーにならず、出力が3.3倍になりました。
xhigh は Sonnet 5 でも機能しています。制限しているのは n8n のUIです。
そしてもう1つ、正直な数字も出ました。答えはどちらも同じでした。 3.3倍のコストを払って、同じ結論に着いただけです。 ただしこれは1問を1回ずつ測っただけなので、これで一般化はできません。
Opus 5 で Thinking Mode を Manual にすると落ちる
Thinking Mode には Disabled / Adaptive (Recommended) / Manual があります。
Manual は古い形式のリクエストを送ります。
モデルに Claude Opus 5、Thinking Mode に Manual を選んで実行した結果です。
400 invalid_request_error
"thinking.type.enabled" is not supported for this model.
Use "thinking.type.adaptive" and "output_config.effort" to control thinking behavior.
実際に送られていたのは thinking: { type: "enabled", budget_tokens: 1024 } でした。
新しいモデルはこの形式を受け付けません。
どちらもドロップダウンに普通に並んでいる選択肢です。 組み合わせただけで到達でき、 保存時の警告もありません。
ただしこの件は、ここまでの4件と性質が違います。静かに壊れるのではなく、はっきり落ちます。 しかもAnthropic側のメッセージが直し方まで書いています。迷うことはありません。 Adaptive を選べば解決します。
新旧のthinking設定を両方立てると、旧が消える
このノードには thinking まわりの設定が2系統あります。
古い Thinking / Thinking Budget と、新しい Thinking Mode / Effort です。
両方を有効にして送られた中身がこれです。
{
  "thinking": { "type": "adaptive" },
  "output_config": { "effort": "low" },
  "max_tokens": 4096
}
budget_tokens はどこにもありません。新しい方が勝ち、古い設定は警告なしに無効化されます。
検証にいくらかかったか
9回の実行の合計です。
| モデル | 実行 | 入力 | 出力 |
|---|---|---|---|
| Claude Haiku 4.5 | 3回 | 36 | 12 |
| Claude Sonnet 4.6 | 1回 | 12 | 4 |
| Claude Sonnet 5 | 5回 | 134 | 2,268 |
合計で約$0.023(およそ3.5円)でした。 挙動を確かめるだけなら、最低額の$5で十分に足ります。
コストが伸びるのは出力トークンです。上の表でも、推論させた2回だけで 出力の97%を占めています。入力を削るより、出力を短くする方が効きます。
確認していないこと
- Claude Fable 5.1 / Opus 5.5 は動かしていません。 一覧には出ますが未検証です
maxeffort は測っていません。 Low と X-High の2点だけですxhighの効果は1問1回ずつの測定です。 他の種類の問題では違う結果になり得ます- n8n のソースは読んでいません。なぜ Sonnet 5 で選択肢を絞っているのかは分かりません
次に読む
同じ「定義に書かれた既定値が実効値ではない」パターンは、 HTTP Requestノードの使い方 の Timeout の節にも書いています。 この記事の Max Tokens は、そこで一度間違えたあとに決めた確認手順で見つけたものです。
Claude Code から n8n を操作して検証する方法は Claude Code と n8n を MCP でつなぐ にまとめています。