中級向け
n8n Remove Duplicatesノードの使い方:実行をまたぐ重複除去は、何をどこに覚えているのか
3つの操作の違いと、実行をまたいだ重複除去が n8n のデータベースに何を保存するかを実際に読んで確かめました。保存されるのは値そのものではなくMD5でした。1回目は重複が残ること、弾かれた分の行方、履歴の消し方まで実測しています。
公開
動作確認: — n8n 2.36.8 / Remove Duplicates ノード v2
Remove Duplicates は、重複したアイテムを取り除くノードです。
同じデータを2回処理してしまう事故は、自動化でよく起きます。APIが同じレコードを返す、 Webhookが二重に飛ぶ、再実行で前回の分まで拾う。そういうときに使います。
このノードには3つの操作があり、そのうち1つは 過去の実行を記憶します。記憶するということは、どこかに保存しているということです。 何が、どこに、どんな形で残るのかを、データベースを直接読んで確かめました。
3つの操作
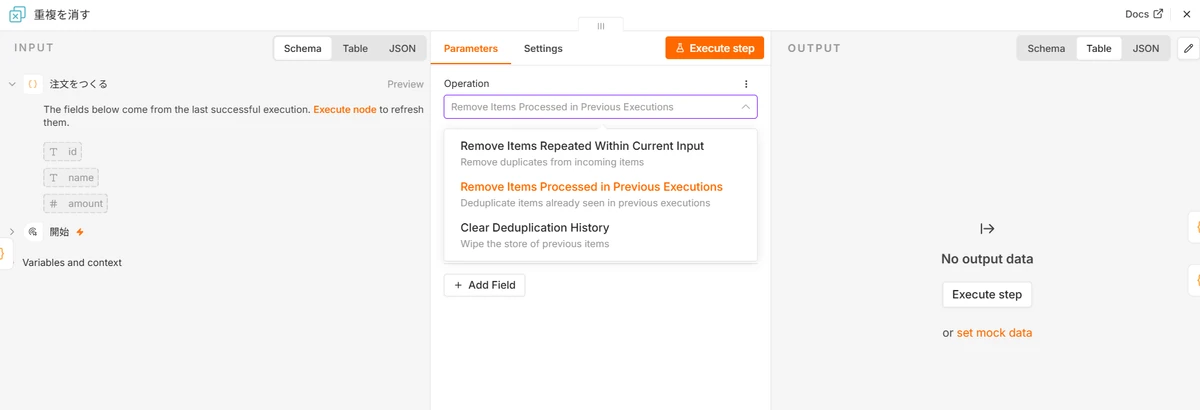
| 表記 | 何をするか |
|---|---|
| Remove Items Repeated Within Current Input | 今回流れてきた分の中の重複を消す |
| Remove Items Processed in Previous Executions | 過去の実行で見たものを消す |
| Clear Deduplication History | 記憶を消す |
名前に Within Current Input と in Previous Executions と書いてあるとおり、 この2つは見ている範囲が違います。 片方がもう片方を兼ねることはありません。
入力内の重複は「最初のもの」が残る
まず素直な方から。id が重複した4件を流しました。
{ id: 'A-1', name: '田中',      amount: 1000 }
{ id: 'A-2', name: '鈴木',      amount: 2000 }
{ id: 'A-1', name: '田中(再送)', amount: 9999 }   // ← id が重複
{ id: 'A-3', name: '佐藤',      amount: 3000 }
Remove Items Repeated Within Current Input で id を比較した結果、3件になりました。
残ったのは amount: 1000 の「田中」 です。
過去の実行を覚える方を使うと、1回目は何も消えない
ここが本題です。同じ4件を Remove Items Processed in Previous Executions で処理しました。
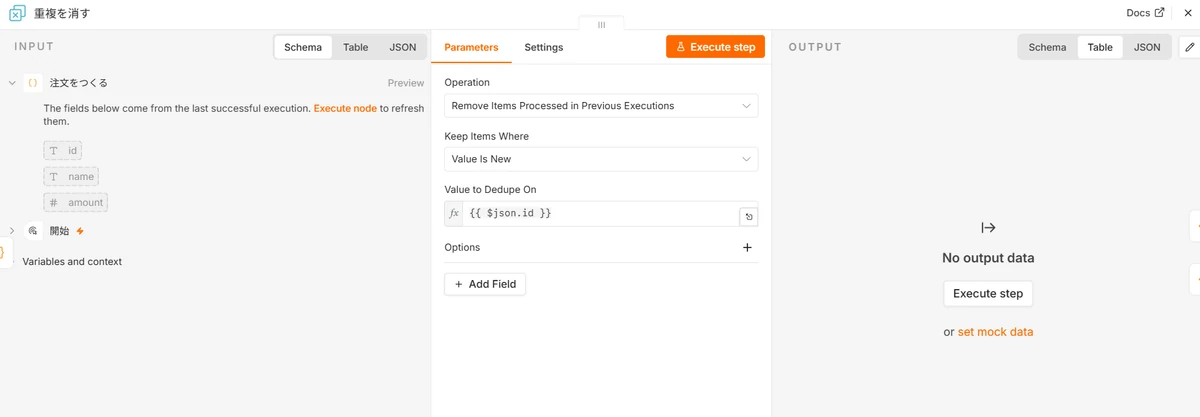
1回目の結果は、4件すべて通過でした。A-1 が2件とも残っています。
2回目に同じ4件を流したら、今度は0件になりました。全部が「見たことがある」と判定されています。
何をどこに覚えているのか
n8n のデータベース(~/.n8n/database.sqlite)を直接読みました。
processed_data というテーブルが使われています。
1回目の実行後、入っていたのは1行だけでした。
workflowId: WWZVFKzT1BE98TZ4
context:    n:bc1f7050-23a8-4022-aa28-21a492309090
value:      {"mode":"entries","data":[
              "RM1CQvTmB2Lu2wY7/kzrPA==",
              "dXN/qIZhxlrAXNze5llsqQ==",
              "Ov8kXf4Ga0rZB/hWeRWzhg=="
]}覚えているのは3件です。4件流して A-1 が重複していたので、ユニークな値は
A-1 / A-2 / A-3 の3つ。数が合います。
context の n: に続く文字列はノードのIDです。これが記憶を分ける単位になります。
Scope で記憶を共有できる
Options に2つの設定があります。
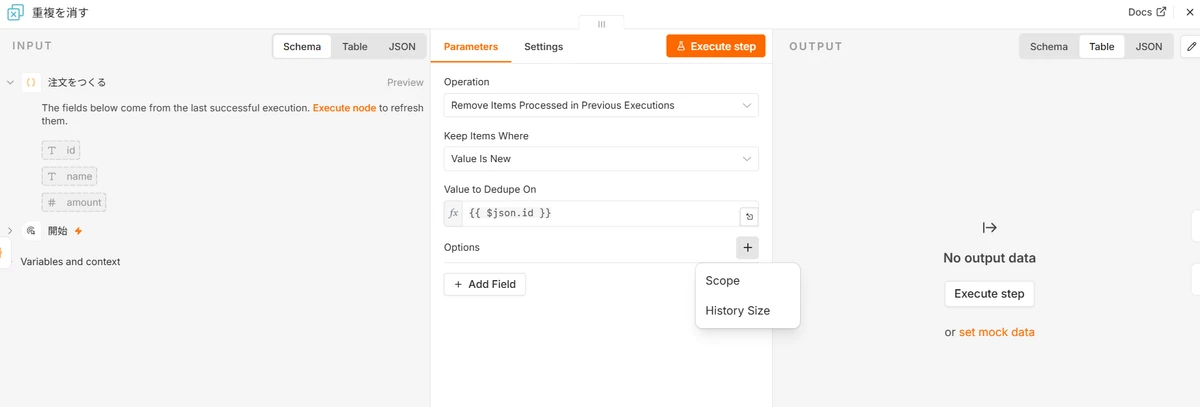
Scope を workflow にして実行し、データベースを見たところ、
context が空文字列になっていました。
| Scope | context の値 |
意味 |
|---|---|---|
node(既定) |
n:<ノードID> |
そのノード専用の記憶 |
workflow |
""(空) |
ワークフロー全体で共有 |
context はこのテーブルの主キーの一部なので、値が変われば別の記憶になります。
同じワークフロー内に Remove Duplicates を複数置いて記憶を共有したいときに
workflow を使います。
History Size は覚えておく件数の上限で、既定は 10000 です。
弾かれた分はどこへ行くのか
Filter ノードとまったく同じ構造でした。
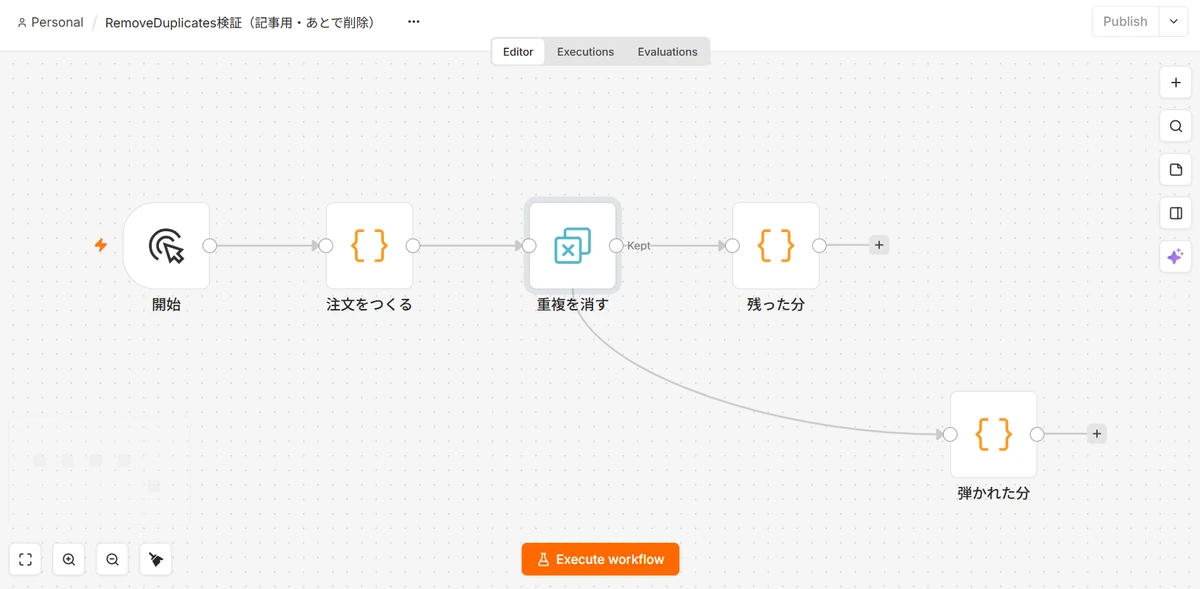
実行データを見ると、出力は2つあります。2回目の実行では1本目が0件、 2本目に弾かれた4件が入っていました。JSONで2本目に繋ぐと、実際に受け取れます。
記憶を消す
Clear Deduplication History を実行すると、processed_data の行が
丸ごと消えました(値を空にするのではなく、行の削除)。
このときアイテムは4件すべてそのまま通過します。順序も変わりません。 データを流すためのノードではなく、記憶を掃除するためのノードです。
使うときに気をつけること
- 1回目は何も消えないことを前提に組む。初回実行で全件が下流へ流れます
- テスト実行も記憶に残る。本番前に
Clear Deduplication Historyを通す - 「最新を残す」用途には向かない。残るのは先に来た方です
- 入力内と実行またぎの両方が必要なら、2つ並べる
検証していないこと
Keep Items WhereはValue Is Newだけ試しました。removeItemsUpToStoredIncrementalKey(増加する値で比較)とremoveItemsUpToStoredDate(日付で比較)は動かしていませんHistory Sizeの上限に達したときの挙動は見ていません。 古いものから捨てられると 思われますが、確認していません- 検証はすべて手動実行です。本番実行で記録のされ方が変わるかは見ていません
Scopeをworkflowにして、複数ノードで実際に記憶を共有させてはいません。contextが空になることを確認しただけです- MD5 で保存されることは確認しましたが、衝突したときにどうなるかは試していません
「重複を消す」と一言で言っても、今回の入力の中を見るのか、過去の実行を見るのかで 別のノードのように振る舞います。そして後者はデータベースに記憶が残り続けます。
- 条件で絞るなら Filterノードの使い方
- データの保存場所とバックアップは n8n をローカルで動かす
- アイテムの考え方は n8n 用語集 に